Jaemin Cho
Jaemin Cho
News
Group
Teaching
Talks
Publications
Vision and Language
Imaginative Perception Tokens Enhance Spatial Reasoning in Multimodal Language Models
Imaginative Perception Tokens enhance spatial reasoning in multimodal language models -
ECCV 2026
Mahtab Bigverdi
,
Linjie Li
,
Weikai Huang
,
Yiming Liu
,
Jaemin Cho
,
Jieyu Zhang
,
Tuhin Kundu
,
Chris Dongjoo Kim
,
Zelun Luo
,
Ranjay Krishna
,
Linda Shapiro
Preprint
Cite
WildDet3D: Scaling Promptable 3D Detection in the Wild
Open-world promptable monocular 3D object detection from a single image
Weikai Huang
,
Jieyu Zhang
,
Sijun Li
,
Taoyang Jia
,
Jiafei Duan
,
Yunqian Cheng
,
Jaemin Cho
,
Matthew Wallingford
,
Rustin Soraki
,
Chris Dongjoo Kim
,
Shuo Liu
,
Donovan Clay
,
Taira Anderson
,
Winson Han
,
Ali Farhadi
,
Bharath Hariharan
,
Zhongzheng Ren
,
Ranjay Krishna
Preprint
Cite
Code
Dataset
Project
SELMA: Learning and Merging Skill-Specific Text-to-Image Experts with Auto-Generated Data
SELMA improves T2I models by fine-tuning on automatically generated multi-skill image-text datasets, with skill-specific LoRA expert learning & merging. -
NeurIPS 2024
Jialu Li
*,
Jaemin Cho
*,
Yi-Lin Sung
,
Jaehong Yoon
,
Mohit Bansal
Preprint
Cite
Code
Project
DiagrammerGPT: Generating Open-Domain, Open-Platform Diagrams via LLM Planning
Using LLM (GPT-4) to generate a ‘diagram plan’ for fine-grained layouts (object/text labels/arrows, etc.) and render in either raster images (via diffusion) and vector graphics (via PowerPoint / Inkscape or any tools). -
COLM 2024
Abhay Zala
,
Han Lin
,
Jaemin Cho
,
Mohit Bansal
Preprint
Cite
Code
Project
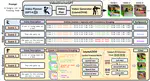
VideoDirectorGPT: Consistent Multi-Scene Video Generation via LLM-Guided Planning
Using LLM (GPT-4) to generate a ‘video plan’ for consistent multi-scene video generation -
COLM 2024
Han Lin
,
Abhay Zala
,
Jaemin Cho
,
Mohit Bansal
Preprint
Cite
Code
Project
DOCCI: Descriptions of Connected and Contrasting Images
High-quality, long, human-annotated descriptions of 15K images -
ECCV 2024
Yasumasa Onoe
,
Sunayana Rane
,
Zachary Berger
,
Yonatan Bitton
,
Jaemin Cho
,
Roopal Garg
,
Alexander Ku
,
Zarana Parekh
,
Jordi Pont-Tuset
,
Garrett Tanzer
,
Su Wang
,
Jason Baldridge
Preprint
Cite
Dataset
Project
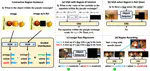
Contrastive Region Guidance: Improving Grounding in Vision-Language Models without Training
CRG is a training-free method that guides VLMs to help understand the visual prompts, by contrasting the outputs with & without visual prompts. -
ECCV 2024
David Wan
,
Jaemin Cho
,
Elias Stengel-Eskin
,
Mohit Bansal
Preprint
Cite
Code
Project
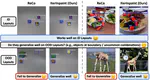
Diagnostic Benchmark and Iterative Inpainting for Layout-Guided Image Generation
a New Diagnostic Benchmark (LayoutBench) and a new Baseline model (IterInpaint) for Layout-Guided Image Generation -
CVPR Workshop 2024
(Oral)
Jaemin Cho
,
Linjie Li
,
Zhengyuan Yang
,
Zhe Gan
,
Lijuan Wang
,
Mohit Bansal
Preprint
Cite
Code
Dataset
Project
Davidsonian Scene Graph: Improving Reliability in Fine-Grained Evaluation for Text-to-Image Generation
Reliable QG/A framework for T2I Evaluation based on Davidsonian Semantics -
ICLR 2024
Jaemin Cho
,
Yushi Hu
,
Roopal Garg
,
Peter Anderson
,
Ranjay Krishna
,
Jason Baldridge
,
Mohit Bansal
,
Jordi Pont-Tuset
,
Su Wang
Preprint
Cite
Code
Project
Self-Chained Image-Language Model for Video Localization and Question Answering
To handle video QA, we self-chain BLIP-2 for 2-stage inference (localize+QA) & refining localization via QA feedback -
NeurIPS 2023
Shoubin Yu
,
Jaemin Cho
,
Prateek Yadav
,
Mohit Bansal
Preprint
Cite
Code
»
Cite
×